Detectar no es monitorizar. Actuar sí.
Detectar una excursión de temperatura en la recepción de mercancías no es un éxito de monitorización. Es un fallo de monitorización con documentación. El producto ya ha estado expuesto, la ventana de intervención ya se ha cerrado y el proceso CAPA ya ha comenzado.
Lo que cambia con la monitorización inteligente de envíos no es la capacidad de registrar lo que ocurrió. Es la capacidad de actuar antes de que ocurra.
Este artículo analiza qué requiere en la práctica el control proactivo de la cadena de frío: visibilidad unificada que elimina puntos ciegos en tránsito, puntuación de riesgo impulsada por IA que saca a la luz lo que de verdad importa, flujos de trabajo de intervención estructurados que hacen que la respuesta sea repetible y herramientas de investigación que convierten cada incidente en una oportunidad de aprendizaje.
Los datos que llegan demasiado tarde son solo pruebas.
Los medicamentos sensibles a la temperatura operan dentro de ventanas de estabilidad estrechas que dejan poco margen de error. Un producto aprobado para almacenarse entre 2 y 8 °C no se vuelve inseguro en el momento en que alcanza 8,1 °C. Pero empieza a consumir su margen de estabilidad, y ese es finito. Una vez agotado, el producto no se puede recuperar. Solo se puede documentar, investigar y dar de baja.
Los costes desencadenados por una sola excursión no detectada van mucho más allá del producto estropeado:
- Baja del producto: las pérdidas pueden oscilar desde decenas de miles hasta varios millones de euros. En el caso de biológicos avanzados y terapias celulares y génicas, un único envío comprometido puede representar un lote irremplazable.
- Envíos rechazados y reabastecimiento: una excursión documentada puede provocar el rechazo, la sustitución urgente y una interrupción del servicio aguas abajo, especialmente crítica en cadenas de suministro hospitalarias o de ensayos clínicos, donde no hay stock de seguridad.
- Carga regulatoria y de CAPA: las excursiones deben documentarse, investigarse y resolverse mediante acciones correctivas y preventivas, consumiendo recursos significativos del equipo de calidad, independientemente de si el producto se vio afectado finalmente.
- Exposición a retiradas: si el producto comprometido llega a los pacientes, las consecuencias se extienden a la logística de retirada, las obligaciones de farmacovigilancia y un daño reputacional que ningún informe de calidad puede cuantificar por completo.
No son casos aislados. Reflejan una brecha estructural: en la mayoría de las cadenas de frío, el estado del envío y las condiciones de temperatura están en herramientas distintas, lo que deja excursiones sin detectar hasta después de la entrega, cuando ya no es posible intervenir. Los datos existían, pero simplemente no estaban disponibles hasta que ya era demasiado tarde para actuar.
La información estaba ahí. La visión completa, no.
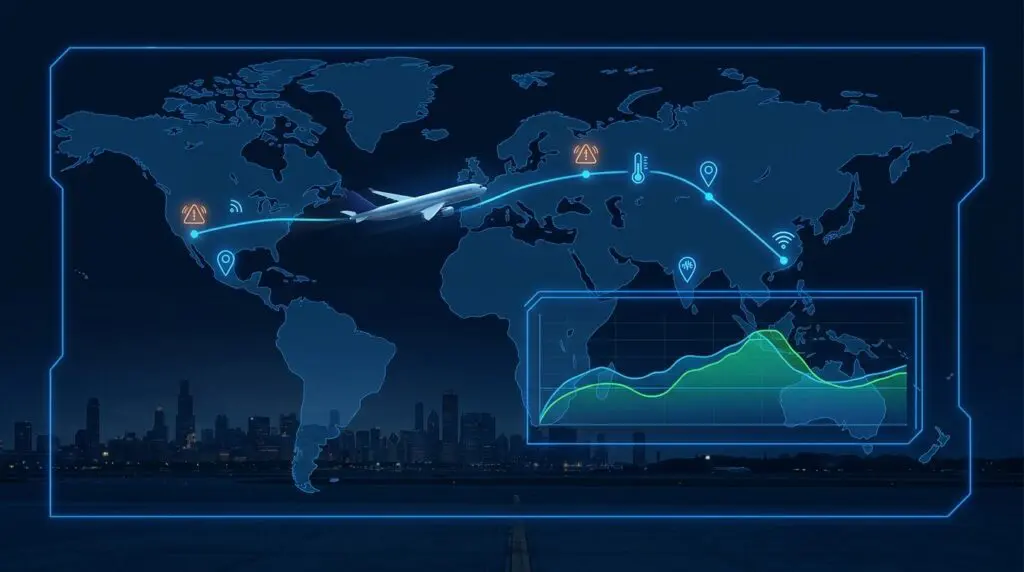
Una vista de monitorización unificada elimina ese retraso. Los datos de condición, los hitos del transportista, los eventos de ubicación y la trayectoria de entrega se ven juntos, en tiempo real, sin cambiar de sistema. La importancia operativa no es solo la velocidad, sino la precisión interpretativa. Una lectura de temperatura significa algo distinto según dónde esté el envío, cuánto tiempo lleve en tránsito, cuánto de su margen de estabilidad se haya consumido ya y si la entrega va según lo previsto.
Un envío que muestra una temperatura nominal pero acumula un retraso de vuelo de seis horas en una ruta con limitaciones térmicas ya es un evento de riesgo. Un sistema que evalúa los datos de condición de forma aislada no lo señalará. Una vista unificada sí.
Esta conciencia contextual es lo que hace que la detección temprana sea operativamente relevante. Detectar una excursión dos horas después de iniciar un tránsito de 48 horas preserva opciones: redirigir, escalar con el transportista, preavisar al destinatario, iniciar un protocolo de contingencia. Detectarla en la recepción de mercancías solo preserva la documentación.
La visibilidad unificada, sin embargo, solo resuelve el problema de la información. A medida que crecen los volúmenes de envíos, surge un segundo reto: no la ausencia de datos, sino la incapacidad de actuar sobre todos a la vez.
De la avalancha de alertas a prioridades clasificadas
La visibilidad genera datos. Los datos generan alertas. Y en una cadena de suministro con decenas o cientos de envíos activos, las alertas sin filtrar generan ruido: un volumen de señales operativamente indistinguible del silencio, porque ningún equipo puede triarlas lo bastante rápido como para actuar sobre lo que importa.
El problema no es que las alertas sean incorrectas. Es que son iguales. Un pico de sensor de dos minutos en un producto con un margen de estabilidad de 72 horas y una entrega confirmada a tiempo se lee igual que una excursión sostenida en un producto que ya ha consumido el 80% de su Tiempo Fuera de Rango (TOR) permitido y va con cuatro horas de retraso. Ambos activan una alerta. Solo uno requiere acción inmediata.
La puntuación de riesgo impulsada por IA resuelve esto sustituyendo el modelo binario activado/no activado por una clasificación continua de severidad, multifactorial, aplicada a cada envío activo en cada actualización de telemetría. Las entradas van mucho más allá de la lectura actual del sensor y pueden incluir:
- TOR acumulado
- trayectoria de entrega
- rendimiento histórico de la ruta
- condiciones externas activas en la ruta, como fenómenos meteorológicos, interrupciones del tráfico y factores geopolíticos
- margen de estabilidad restante
El resultado es una vista clasificada y actualizada continuamente de toda la flota activa, generada automáticamente sin puntuación manual y sin necesidad de analistas. Los envíos que requieren acción inmediata aparecen arriba; los que están en observación se siguen sin generar ruido, mientras que los que avanzan con normalidad no requieren atención en absoluto.
El resultado operativo es un equipo que dedica su tiempo a las excepciones que de verdad importan, en lugar de al proceso de determinar cuáles son esas excepciones.
Convertir la detección en acción con responsabilidad
Una puntuación de riesgo que saca a la luz el envío correcto en el momento adecuado no tiene valor si la respuesta posterior es improvisada, no se registra o se dirige a la persona equivocada. La detección sin ejecución estructurada sigue siendo una brecha, solo que más tarde.
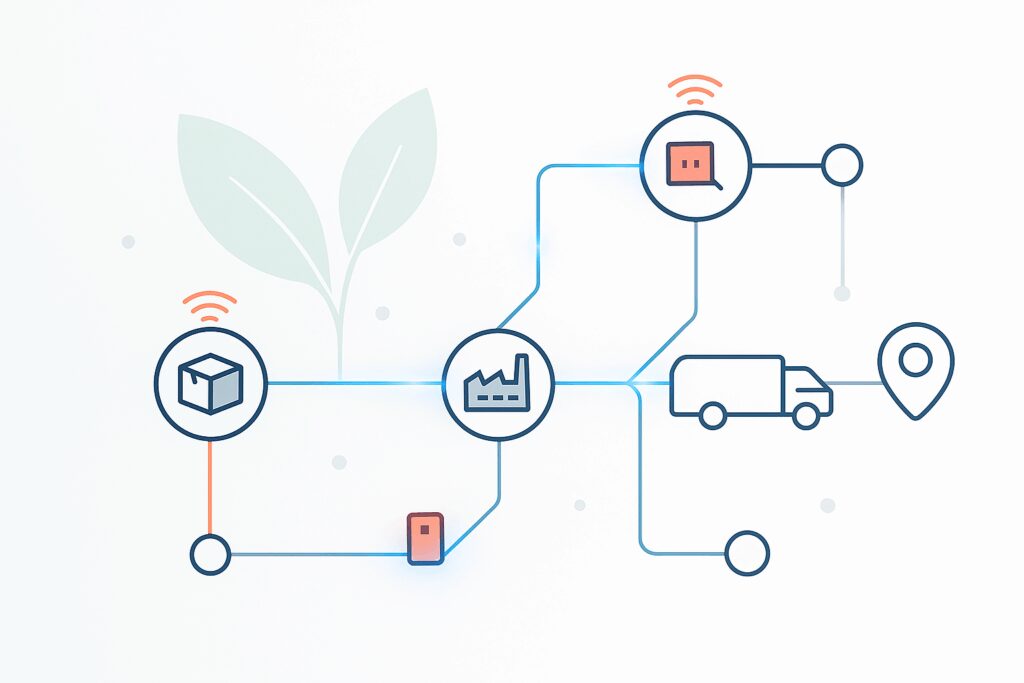
Una gestión eficaz de excepciones debe empezar por un enrutamiento estructurado. Cuando se produce un evento señalado, debe asignarse a un responsable nominal en función de la naturaleza de la excepción: el contacto del transportista para la intervención física, el transitario para la coordinación logística, el responsable de QA para la disposición, el destinatario para la preparación de la recepción. La persona asignada no debe recibir una alerta en bruto, sino una tarea estructurada que comunique qué ha pasado, cuánto tiempo lleva desarrollándose la condición, cuál es el margen de estabilidad restante y qué pasos alineados con los Procedimientos Operativos Estándar se requieren para resolverlo.
Cada acción realizada debe llevar marca de tiempo y atribuirse a una persona identificada. Las escaladas deben registrarse formalmente. Ninguna acción debe poder descartarse en silencio. Cuando se requiere una decisión de calidad, la excepción debe pasar a un flujo de aprobación estructurado: el revisor de calidad debe recibir el registro completo del incidente, no un resumen reconstruido a partir de la memoria o hilos de correo, con una transferencia completa y a prueba de manipulaciones que preserve la integridad del rastro de decisión.
Este nivel de trazabilidad no es carga administrativa. Es un requisito de cumplimiento. Bajo los marcos GDP y GxP, las organizaciones deben poder demostrar que cada desviación se detectó, se asignó, se actuó sobre ella y se cerró formalmente, con evidencia documentada en cada paso. La capacidad de generar ese registro bajo demanda es lo que separa un proceso de calidad defendible de uno que depende de la memoria institucional. Y es precisamente este registro documentado el que hace posible el siguiente paso: convertir un incidente cerrado en una fuente de inteligencia operativa.
Donde los incidentes individuales se convierten en inteligencia sistémica
La investigación estructurada posterior al incidente requiere una vista cronológica que correlacione cuándo y dónde empezó la excursión, en qué tramo de la ruta ocurrió, qué entrega al transportista o retención en aduanas la precedió y cuánto tiempo llevaba el envío acumulando estrés térmico antes de cruzar el umbral.
Una línea de tiempo interactiva del envío superpone hitos, eventos de ubicación, datos de pings y marcadores de excursión sobre la curva de temperatura a lo largo de todo el trayecto. La identificación de la causa raíz, que antes requería horas de cruce de referencias entre fuentes de datos separadas, puede completarse en minutos, con la evidencia ya reunida y defendible para una revisión regulatoria. El valor se multiplica con el tiempo. Cada investigación retroalimenta el sistema, impulsando:
- Actualizaciones del perfil de ruta: umbrales más estrictos, puntos de control de monitorización adicionales, ajuste del momento de alerta para segmentos específicos
- Revisiones del rendimiento del transportista: los patrones de fallo en hubs de tránsito específicos se vuelven visibles y atribuibles
- Recalificación del embalaje: se identifican y corrigen configuraciones que se degradan demasiado rápido en condiciones estacionales
Agregados a través de múltiples envíos, estos hallazgos impulsan actualizaciones de cualificación de rutas y una selección de rutas y proveedores basada en evidencias. Cada incidente, investigado correctamente, se convierte en un dato que hace que el siguiente envío sea más seguro.
Cumplimiento, integración y el camino a seguir
El GDP de la UE y la FDA 21 CFR Parte 11 exigen equipos calibrados, registros electrónicos fiables, trazas de auditoría y controles de acceso. Los sistemas de monitorización inteligente abordan todo esto por diseño e integran con entornos ERP, WMS y QMS existentes mediante APIs, de modo que los equipos no necesitan una migración completa para beneficiarse.
Volviendo a las cifras citadas antes: si las excursiones afectan al 15–20% de los envíos farmacéuticos a nivel mundial y una cuarta parte de los productos sensibles a la temperatura llegan ya degradados, la pregunta no es si los fallos de la cadena de frío son un riesgo operativo y financiero significativo
La pregunta es cuánto de ese riesgo se puede recuperar con los sistemas adecuados.
La respuesta depende por completo de en qué punto del ciclo de vida del envío se detecta un problema, con qué rapidez se notifica a la persona adecuada y si la organización aprende algo del incidente antes de que salga el siguiente envío.
La monitorización inteligente de envíos no elimina el riesgo de la cadena de frío. Ayuda a identificar los riesgos antes de que surjan y reduce el tiempo entre la aparición del riesgo y la acción, hace que esa acción sea coherente y trazable, y garantiza que cada incidente contribuya a reducir la probabilidad del siguiente. Eso es lo que separa una solución de monitorización que protege la calidad del producto de otra que solo documenta su pérdida.